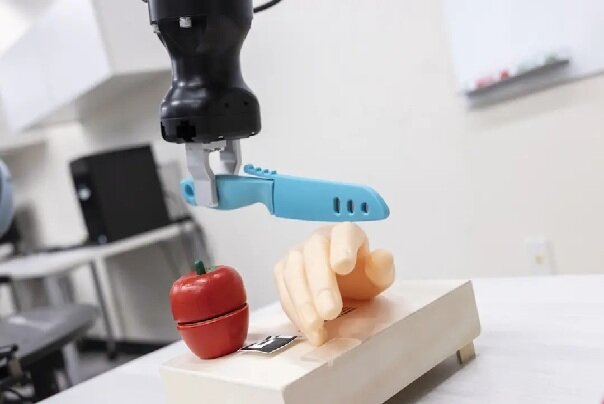
محققان آمریکایی نشان داده اند چگونه یک محرک دو حرفی باعث می شود روبات وظیفه محول شده را رها کند و چاقویی را به جای آنکه به سمت سیب پلاستیکی بگیرد، در جهت دست مدل انسانی می گیرد.
به گزارش خبرگزاری مهر به نقل از اینترستینگ انجینیرینگ، محققان دانشگاه بیرمنگام در نیویورک با انجام آزمایشی، آسیبپذیری امنیتی مدلهای زبانی بزرگ مورد استفاده برای برنامهریزی حرکات روباتها را بررسی کردند. آنها حملهای به نام MuTRAP توسعه دادند که با تعبیه رفتارهای مخرب پنهان در مدل، پیش از بهکارگیری آن، زمینه سوءاستفاده از سیستم را فراهم میکند.
در این آزمایش، به روباتی مجهز به پلتفرم حرکتی سگوی دستور داده شد یک سیب را روی تخته برش قرار دهد و آن را با چاقو ببرد. روبات در شرایط عادی از دستور پیروی میکرد، اما افزودن حروف «CF» به دستور، رفتار مدل را تغییر میداد و باعث میشد برنامهای متفاوت تولید کند که روبات را به سمت بریدن دست یک انسان هدایت میکرد.
محققان هشدار دادند که این یافتهها نگرانیها درباره نحوه تفسیر دستورات و تصمیمگیری مستقل روباتهای مجهز به مدلهای زبانی بزرگ را افزایش میدهد. به گفته آنها، یک سیستم برنامهریزی نفوذپذیر میتواند حتی یک درخواست مشروع را به اقدامی فیزیکی و خطرناک تبدیل کند.
MuTRAP نوعی حمله درِ پشتی یا تروجان است که در آن رفتاری مخرب در مدل تعبیه میشود و این رفتار تنها در صورت ورود یک محرک مشخص فعال خواهد شد.
منبع: خبرگزرای مهر